CLI für KI-Agenten: Bis zu 83 % weniger Tokens in Unity, Unreal und Godot
KI-Agenten beim Kaltstart mit unseren Unity-, Unreal- und Godot-CLIs: Tokenverbrauch um bis zu 83 % gesenkt. Was wir geändert haben und was wir lernten.
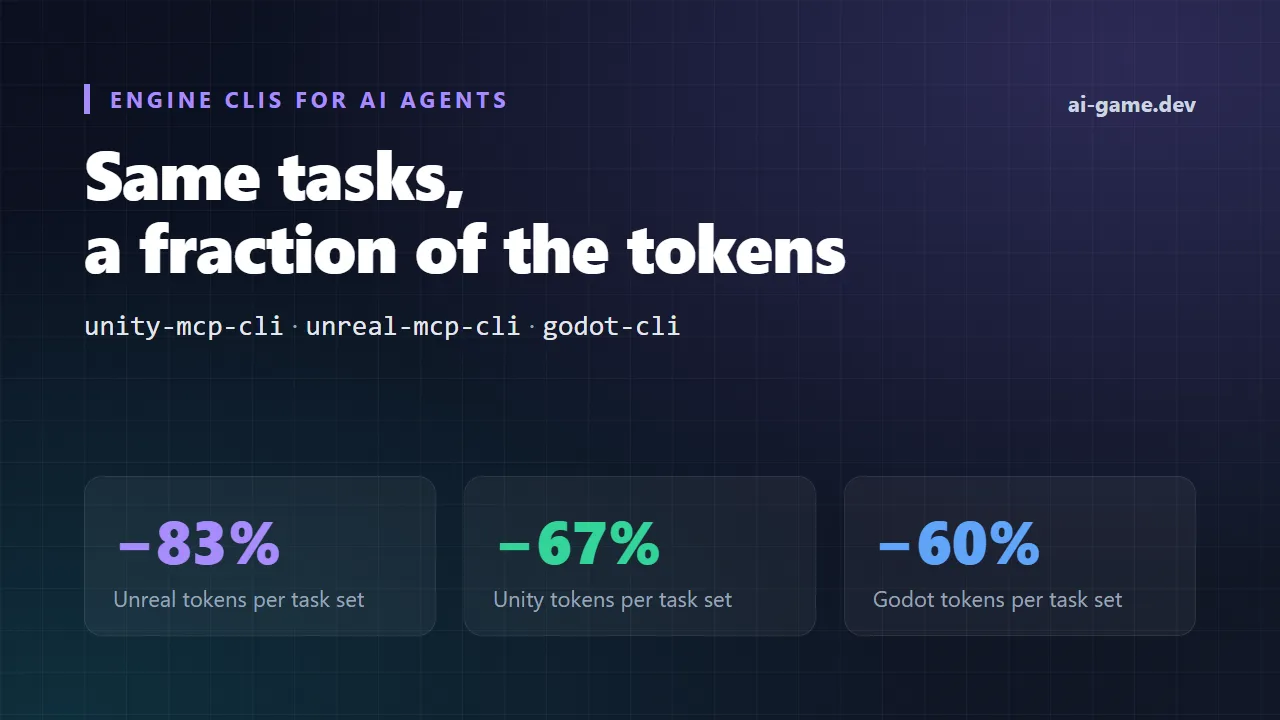
Unsere drei Kommandozeilen-Werkzeuge für Engines, unity-mcp-cli, unreal-mcp-cli und godot-cli, kosten KI-Agenten jetzt deutlich weniger. Bei denselben Editor-Aufgaben verbraucht ein Agent beim Kaltstart 60 % bis 83 % weniger Tokens und macht merklich weniger Tool-Aufrufe als mit den vorherigen Versionen. Dahin kamen wir mit etwas Einfachem, das ein wenig demütigend war: Wir gaben einem kleinen KI-Agenten nichts außer der CLI, sahen zu, wo er hängen blieb, behoben das und haben erneut gemessen.
Dieser Beitrag geht durch die drei Runden dieser Arbeit, die Zahlen (auch die, die in die falsche Richtung ging) und die Lehren, die für alle gelten, die eine CLI für KI-Agenten bauen. Wenn du Claude Code, Codex oder einen anderen Agenten mit Unity, Unreal Engine oder Godot nutzt, bedeuten diese Änderungen kürzere Sitzungen, weniger Wiederholungen und eine kleinere Rechnung.
Wie wir eine CLI für KI-Agenten getestet haben
Jeder Lauf in jeder Runde verwendete dasselbe strikte Setup, sodass die Ergebnisse widerspiegeln, was ein echter Agent auf einer echten Maschine vorfindet:
- Der Agent ist ein kleines, schnelles LLM (DeepSeek Flash). Ein kleines Modell zeigt raue Kanten, die ein großes Modell still umgeht.
- Er bekommt nur die CLI und einfache Dateiwerkzeuge. Keine MCP-Verbindung, keine Dokumentation, keine Hinweise im Prompt.
- Er startet kalt: ein frisches Projekt, die Engine geschlossen, nichts im Cache.
- Ein Lauf gilt nur als bestanden, wenn der echte Endzustand stimmt: die Szenen- oder Level-Dateien auf der Festplatte oder das Compile-Ergebnis. Was der Agent behauptet getan zu haben, zählt nicht.
Wir zählten die Tokens, die der Agent las und schrieb, die Anzahl der Züge oder Tool-Aufrufe, die Tool-Fehler und die bestandenen Aufgaben. Dann lasen wir die Transkripte, denn die Zahlen sagen dir, dass etwas langsam ist, und die Transkripte sagen dir, warum.
Runde 1: Findet ein Agent seinen Weg?
Die ersten Transkripte waren ernüchternd. Agenten fanden die KI-Tools des Editors überhaupt nicht. Wenn die CLI „not logged in“ meldete, bearbeiteten sie Konfigurationsdateien von Hand, um daran vorbeizukommen. Sie rieten Befehlspanne, die es nicht gab. Nichts davon ist die Schuld des Agenten: Die CLI sagte ihm einfach nicht, was es wissen musste.
Die erste Runde der Korrekturen drehte sich also ums Auffinden:
- Ein neuer Befehl tools listet die KI-Tools des Editors auf, auch wenn die Engine geschlossen ist. Er startet einmal einen Headless-Editor, legt die Liste im Cache ab und antwortet danach aus dem Cache.
- Die Ausgabe von --help endet jetzt mit einem kurzen Fußteil zum Alltagsworkflow: die Handvoll Befehle, die ein Agent wirklich braucht, in der Reihenfolge, in der er sie braucht.
- Eine Maschine, die nie bei ai-game.dev angemeldet war, bekommt jetzt einen lokalen Server statt einer Sackgasse. Eine angemeldete Maschine bleibt immer in der Cloud.
- Der Headless-Editor übersteht Compile-Fehler und teilt dem Agenten mit, wo das Log liegt, statt wortlos zu scheitern.
- Neue Befehle test und compile (bei godot-cli heißt er check), dazu ein Befehl dialog für Unity und Unreal, der die modalen Dialoge auflistet, die den Editor blockieren, und einen Button in einem davon drücken kann.
- Die Exit-Codes sind bei allen drei CLIs gleich, und die Befehle für Agenten akzeptieren --format json für Ausgaben, die ein Skript parsen kann.
Vergleich der ersten mit der letzten Runde dieser Phase (ein Lauf pro Aufgabe):
- Unity: Input-Tokens 275k → 104k (−62 %), Züge 46 → 30.
- Godot: Input-Tokens 598k → 203k (−66 %), Züge 71 → 40, bestandene Aufgaben 3/4 → 4/4, Tool-Fehler 27 → 6.
- Unreal: Input-Tokens 383k → 414k (+8 %), Züge 66 → 60, Tool-Fehler 13 → 8.
Über alle drei Engines hinweg brauchte der Agent pro gelöster Aufgabe 1,9-mal weniger Input-Tokens (114k → 60k) und bestand 12 von 12 Aufgaben statt 11 von 12.
Ja, bei Unreal ging es nach oben. Der Agent machte weniger Fehler und war in weniger Zügen fertig, las unterwegs aber mehr. Runde 1 behob, was der Agent finden konnte. Sie behob noch nicht, wie viel er lesen musste, und darum ging es in der nächsten Runde.
Runde 2: Jedes frühe Byte wird in jedem Zug erneut bezahlt
Die zentrale Erkenntnis dieser Runde ist einfach, sobald man sie sieht. Die Konversation eines Agenten wächst mit jedem Schritt, und alles, was er früh gelesen hat, wird bei jedem späteren Zug erneut an das Modell geschickt. Eine große Hilfe-Seite, die im ersten Zug gelesen wird, wird im zweiten, zehnten und dreißigsten Zug erneut bezahlt.
In der Ausgangsbasis machte die --help auf oberster Ebene (4,8 KB und immer das Erste, was ein Agent liest) 43 % des Token-Gewichts aller Tool-Ausgaben aus. Das RQL-Schema machte weitere 24 % aus. Zwei frühe Lesezugriffe waren zwei Drittel der Kosten.
Die Korrekturen:
- Eine kurze --help mit gebrauchsfertigen RQL-Rezepten, sodass der Agent eine funktionierende Abfrage kopieren kann, statt eine Referenz zu studieren.
- Eine kompakte Schema-Übersicht statt der vollständigen.
- RQL-Fehler, die einen Hinweis auf die richtige Quelle oder den richtigen Member-Namen enthalten.
- Ein vollwertiger Befehl rql, der die Abfrage als einfaches Argument entgegennimmt, ohne JSON-Quoting, bei dem man etwas falsch machen kann.
- Speichervorgänge, die die auf die Festplatte geschriebenen Dateien ausgeben. Agenten brauchten früher 4 bis 9 zusätzliche Aufrufe, um zu prüfen, ob ein Speichern wirklich stattgefunden hat.
RQL ist die Abfragesprache, mit der unsere Editor-Tools Szenen, Objekte, Komponenten und Assets lesen und ändern. Mehr dazu unter ai-game.dev/docs/rql.
Wir haben jede Idee einzeln gemessen, bevor wir die nächste daraufgesetzt haben. Bei Unreal mit drei Läufen pro Aufgabe sah die Leiter so aus:
- Ausgangsbasis: 403k Tokens, 60 Tool-Aufrufe.
- Kurze Hilfe mit Rezepten, kompaktes Schema, RQL-Hinweise: 123k Tokens (−69 %).
- Plus der vollwertige Befehl rql: 106k Tokens (−74 %).
- Plus Speichervorgänge, die die geschriebenen Dateien ausgeben: 68k Tokens (−83 %), 31 Tool-Aufrufe (−48 %).
Dieselben Änderungen auf alle drei CLIs angewendet, bei jedem Lauf vom Kaltstart aus gemessen (Unreal drei Läufe pro Aufgabe, Unity und Godot zwei):
- Unreal: Tokens 403k → 68k (−83 %), Tool-Aufrufe 60 → 31.
- Unity: Tokens 248k → 82k (−67 %), Tool-Aufrufe 33,5 → 26, bestandene Aufgaben 4/4.
- Godot: Tokens 131k → 53k (−60 %), Tool-Aufrufe 34 → 28,5, bestandene Aufgaben 4/4.
Runde 3: Ein kleiner Skill, geschrieben von der CLI selbst
Viele Agenten unterstützen Skills: kurze Anweisungsdateien, die der Agent lädt, wenn eine Aufgabe dazu passt. Der Befehl setup-skills jeder CLI schreibt jetzt einen Skill von etwa 2,2 KB, offline, ohne laufenden Editor. Der Skill wird aus derselben Quelle erzeugt wie --help, sodass die beiden nie auseinanderdriften können.
Wir verglichen Agenten ohne Skill mit Agenten mit Skill, beide auf der optimierten CLI, über drei Editor-Aufgaben und 207 isolierte Läufe hinweg:
- Unity: Tokens 160k → 60k (−63 %), Tool-Aufrufe 42 → 23, 18/18 bestanden.
- Unreal: Tokens 87k → 53k (−39 %), Tool-Aufrufe 37 → 24, 9/9 bestanden.
- Godot: Tokens 117k → 81k (−31 %), Tool-Aufrufe 49 → 39, 18/18 bestanden.
Drei Dinge haben uns beim Feintuning des Skills überrascht:
- Ein kürzerer Skill war besser als ein längerer. Jede Zeile eines Skills wird in jedem Zug erneut gelesen, genau wie die Hilfe.
- Eine als Warnung formulierte Regel brachte Agenten zu zusätzlichen Prüfungen. Die schlichte Feststellung der Tatsache funktionierte besser als eine Warnung davor.
- Bei Aufgaben, die nur Code betreffen, hilft der Skill kaum. Sein Wert liegt in der Editor-Arbeit: Szenen, Levels, Objekte und Assets.
Lehren für alle, die eine CLI für KI-Agenten bauen
Nichts davon ist spezifisch für Game-Engines. Wenn du ein Kommandozeilen-Werkzeug baust, das KI-Agenten nutzen werden, sind das die Lehren, die wir weitergeben würden:
- Packe den Workflow und die Rezepte in --help. Agenten lesen zuerst die Hilfe. Gib ihnen die fünf Befehle, die zählen, und je ein funktionierendes Beispiel, keine vollständige Referenz.
- Halte frühe Ausgaben winzig. Was ein Agent in seinen ersten Zügen liest, wird in jedem späteren Zug erneut bezahlt. Kürze den ersten Bildschirm radikal.
- Mach Ergebnisse selbstüberprüfend. Wenn ein Speichern „Saved to disk“ mit den Dateipfaden ausgibt, hört der Agent auf, Aufrufe zum Nachprüfen zu verbrauchen.
- Gib jedem Fehler einen nächsten Schritt. Ein Fehler, der die gültigen Optionen nennt, verwandelt eine Sackgasse in einen weiteren Aufruf.
- Messe mit einem Kaltstart-Eval. Nutze ein kleines Modell, ein frisches Projekt und eine Prüfung des echten Endzustands. Lies die Transkripte, ändere eine Sache und messe erneut.
Ausprobieren
Die neuen Befehle sind im neuesten Release jedes Engine-Plugins verfügbar: unity-mcp-cli 1.11.1, unreal-mcp-cli 0.31.1 und godot-cli 0.39.1. Wenn unity-mcp-cli --help (oder das Unreal- bzw. Godot-Äquivalent) rql und tools nicht auflistet, bist du auf einer älteren Version, und der Befehl update bringt dich auf die neueste.
npx unity-mcp-cli tools
npx unity-mcp-cli rql 'objects | where name starts-with "Tree" | count'
npx unity-mcp-cli compile
npx unity-mcp-cli setup-skills claude-codenpx unreal-mcp-cli tools --filter rql
npx unreal-mcp-cli rql 'actors | where Label starts-with "Rock" | set Scale = Scale * 1.5'
npx unreal-mcp-cli rql 'editor | call SaveLevel()'npx godot-cli rql 'nodes | where name contains "Enemy" | count'
npx godot-cli check
npx godot-cli setup-skills claude-codeDer erste Editor-Befehl startet einen Headless-Editor und hält ihn warm, sodass du die Engine nicht zuerst öffnen musst. Eine mit rql vorgenommene Änderung gibt aus, was sich geändert hat und welche Dateien geschrieben wurden, sodass dein Agent direkt zum nächsten Schritt übergehen kann.
Erste Schritte
- Unity: ai-game.dev/engines/unity
- Unreal Engine: ai-game.dev/engines/unreal
- Godot: ai-game.dev/engines/godot
- Die Abfragesprache RQL: ai-game.dev/docs/rql
- Quickstart-Anleitung: ai-game.dev/docs/quickstart
- Discord-Community: https://discord.gg/cfbdMZX99G
Wir werden diese Kaltstart-Evals weiterlaufen lassen, während die CLIs wachsen. Wenn dein Agent irgendwo hängen bleibt, sag es uns auf Discord: ein Transkript davon, wo es schiefging, ist genau das, was wir brauchen.