CLI para agentes de IA: hasta un 83% menos de tokens en Unity, Unreal y Godot
Observamos a agentes de IA usar nuestras CLI de Unity, Unreal y Godot desde cero y recortamos su uso de tokens hasta un 83%. Qué cambiamos y qué aprendimos.
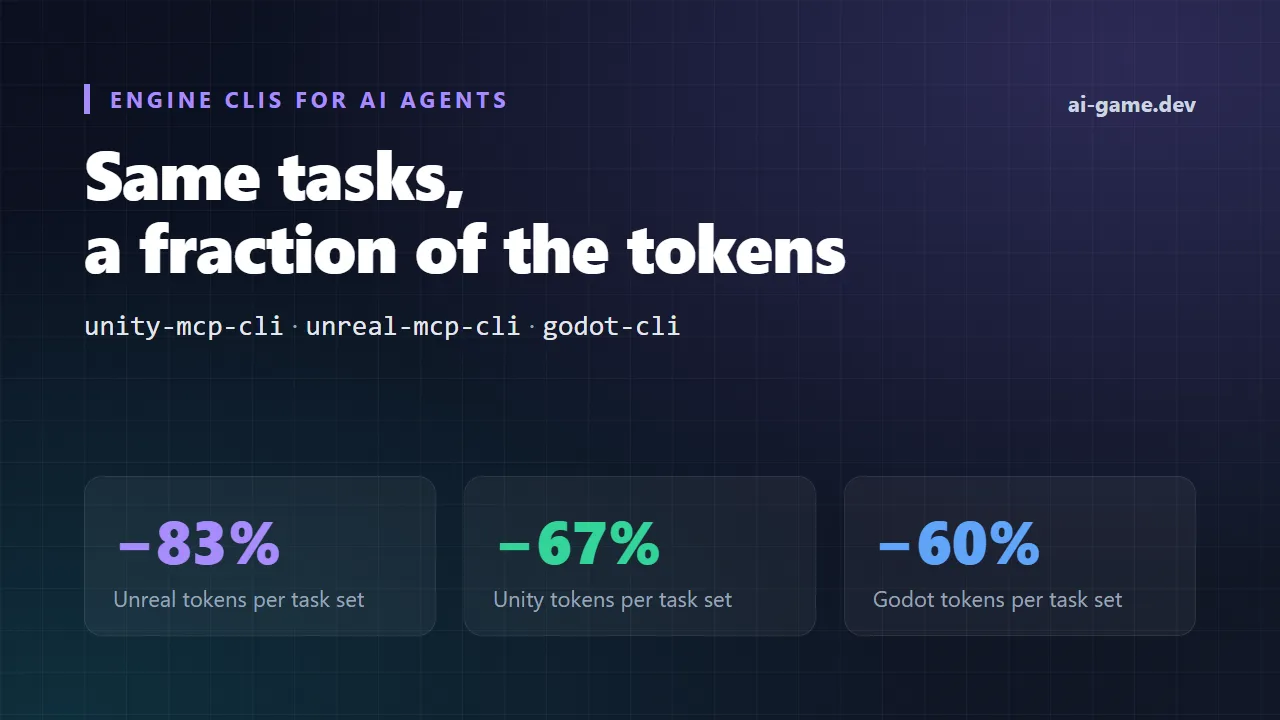
Nuestras tres herramientas de línea de comandos para motores, unity-mcp-cli, unreal-mcp-cli y godot-cli, ahora les cuestan mucho menos de usar a los agentes de IA. En las mismas tareas de editor, un agente que arranca en frío gasta entre un 60% y un 83% menos de tokens y hace notablemente menos llamadas a herramientas que con las versiones anteriores. Lo conseguimos haciendo algo sencillo y un poco humillante: le dimos a un agente de IA pequeño solo la CLI, observamos dónde se atascaba, lo arreglamos y volvimos a medir.
Esta entrada repasa las tres rondas de ese trabajo, los números (incluido el que fue en la dirección equivocada) y las lecciones que sirven a cualquiera que esté construyendo una CLI para agentes de IA. Si usas Claude Code, Codex u otro agente con Unity, Unreal Engine o Godot, estos cambios significan sesiones más cortas, menos reintentos y una factura más pequeña.
Cómo probamos una CLI para agentes de IA
Cada ejecución de cada ronda usó la misma configuración estricta, para que los resultados reflejen lo que un agente real encuentra en una máquina real:
- El agente es un LLM pequeño y rápido (DeepSeek Flash). Un modelo pequeño deja ver las asperezas que un modelo grande esquiva en silencio.
- Solo recibe la CLI y herramientas básicas de archivos. Sin conexión MCP, sin documentación, sin pistas en el prompt.
- Arranca en frío: un proyecto nuevo, el motor cerrado, nada en caché.
- Una ejecución solo se considera superada si el estado final real es correcto: los archivos de escena o de nivel en disco, o el resultado de la compilación. Lo que el agente diga que hizo no cuenta.
Contamos los tokens que el agente leyó y escribió, el número de turnos o de llamadas a herramientas, los errores de herramientas y las tareas superadas. Después leímos las transcripciones, porque los números te dicen que algo va lento y las transcripciones te dicen por qué.
Ronda 1: ¿Puede un agente encontrar su camino?
Las primeras transcripciones fueron duras. Los agentes no encontraban las herramientas de IA del editor. Cuando la CLI decía "sesión no iniciada", editaban archivos de configuración a mano para saltárselo. Adivinaban nombres de comandos que no existían. Nada de eso es culpa del agente: la CLI simplemente no le decía lo que necesitaba saber.
Así que la primera ronda de arreglos fue sobre descubrimiento:
- Un nuevo comando tools lista las herramientas de IA del editor incluso cuando el motor está cerrado. Arranca un editor sin interfaz una vez, guarda la lista en caché y a partir de ahí responde desde la caché.
- La salida de --help ahora termina con un breve pie de flujo de trabajo diario: el puñado de comandos que un agente realmente necesita, en el orden en que los necesita.
- Una máquina que nunca inició sesión en ai-game.dev ahora recibe un servidor local en lugar de un callejón sin salida. Una máquina con sesión iniciada siempre se queda en la nube.
- El editor sin interfaz sobrevive a los errores de compilación y le dice al agente dónde está su log, en lugar de fallar sin decir nada.
- Nuevos comandos test y compile (godot-cli lo llama check), además de un comando dialog para Unity y Unreal que lista los diálogos modales que bloquean el editor y puede pulsar un botón en uno de ellos.
- Los códigos de salida son los mismos en las tres CLI, y los comandos orientados al agente aceptan --format json para producir una salida que un script pueda interpretar.
Comparando la primera ronda con la ronda final de esta fase (una ejecución por tarea):
- Unity: tokens de entrada 275k → 104k (−62%), turnos 46 → 30.
- Godot: tokens de entrada 598k → 203k (−66%), turnos 71 → 40, tareas superadas 3/4 → 4/4, errores de herramientas 27 → 6.
- Unreal: tokens de entrada 383k → 414k (+8%), turnos 66 → 60, errores de herramientas 13 → 8.
En los tres motores, el agente usó 1,9 veces menos tokens de entrada por tarea resuelta (114k → 60k) y superó 12 de 12 tareas en lugar de 11 de 12.
Sí, Unreal subió. El agente cometió menos errores y terminó en menos turnos, pero leyó más por el camino. La ronda 1 arregló lo que el agente podía encontrar. Todavía no arreglaba cuánto tenía que leer, y de eso iba la siguiente ronda.
Ronda 2: cada byte temprano se vuelve a pagar en cada turno
La idea clave de esta ronda es sencilla en cuanto la ves. La conversación de un agente crece con cada paso, y todo lo que leyó al principio se envía al modelo otra vez en cada turno posterior. Una página de ayuda enorme leída en el turno uno se vuelve a pagar en el turno dos, en el diez y en el treinta.
En la línea base, el --help raíz (4,8 KB, y siempre lo primero que lee un agente) suponía el 43% del peso en tokens de toda la salida de herramientas. El esquema de RQL suponía otro 24%. Dos lecturas tempranas eran dos tercios del coste.
Los arreglos:
- Un --help corto con recetas de RQL listas para usar, para que el agente pueda copiar una consulta que funciona en lugar de estudiar una referencia.
- Un resumen compacto del esquema en lugar del completo.
- Errores de RQL que incluyen una pista sobre el nombre correcto de la fuente o del miembro.
- Un comando rql de primera clase que recibe la consulta como argumento simple, sin comillas JSON en las que equivocarse.
- Operaciones de guardado que imprimen los archivos que escribieron en disco. Antes los agentes gastaban de 4 a 9 llamadas extra comprobando que el guardado realmente había ocurrido.
RQL es el lenguaje de consultas que usan nuestras herramientas de editor para leer y cambiar escenas, objetos, componentes y assets. Puedes leer más sobre él en ai-game.dev/docs/rql.
Medimos cada idea por separado antes de apilar la siguiente encima. En Unreal, con tres ejecuciones por tarea, la escalera quedó así:
- Línea base: 403k tokens, 60 llamadas a herramientas.
- Ayuda corta con recetas, esquema compacto, pistas de RQL: 123k tokens (−69%).
- Más el comando rql de primera clase: 106k tokens (−74%).
- Más guardados que imprimen los archivos escritos: 68k tokens (−83%), 31 llamadas a herramientas (−48%).
Los mismos cambios aplicados a las tres CLI, medidos desde un arranque en frío en cada ejecución (Unreal tres ejecuciones por tarea, Unity y Godot dos):
- Unreal: tokens 403k → 68k (−83%), llamadas a herramientas 60 → 31.
- Unity: tokens 248k → 82k (−67%), llamadas a herramientas 33,5 → 26, tareas superadas 4/4.
- Godot: tokens 131k → 53k (−60%), llamadas a herramientas 34 → 28,5, tareas superadas 4/4.
Ronda 3: una pequeña skill escrita por la propia CLI
Muchos agentes admiten skills: archivos breves de instrucciones que el agente carga cuando una tarea encaja. El comando setup-skills de cada CLI ahora escribe una skill de unos 2,2 KB, sin conexión, sin ningún editor en marcha. La skill se genera desde la misma fuente que --help, así que las dos nunca pueden divergir.
Comparamos agentes sin skill con agentes con la skill, ambos sobre la CLI optimizada, en tres tareas de editor y 207 ejecuciones aisladas:
- Unity: tokens 160k → 60k (−63%), llamadas a herramientas 42 → 23, 18/18 superadas.
- Unreal: tokens 87k → 53k (−39%), llamadas a herramientas 37 → 24, 9/9 superadas.
- Godot: tokens 117k → 81k (−31%), llamadas a herramientas 49 → 39, 18/18 superadas.
Tres cosas nos sorprendieron al ajustar la skill:
- Una skill más corta superó a una más larga. Cada línea de una skill se vuelve a leer en cada turno, igual que la ayuda.
- Una regla redactada como advertencia hacía que los agentes ejecutaran comprobaciones extra. Enunciar el hecho sin más funcionó mejor que advertir sobre él.
- Para tareas que solo tratan de código, la skill no ayuda mucho. Su valor está en el trabajo de editor: escenas, niveles, objetos y assets.
Lecciones para quien construya una CLI para agentes de IA
Nada de esto es específico de los motores de juego. Si construyes una herramienta de línea de comandos que van a usar agentes de IA, estas son las lecciones que transmitiríamos:
- Pon el flujo de trabajo y las recetas en --help. Los agentes leen la ayuda primero. Dales los cinco comandos que importan y un ejemplo funcional de cada uno, no una referencia completa.
- Mantén diminuta la salida temprana. Todo lo que un agente lee en sus primeros turnos se vuelve a pagar en cada turno posterior. Recorta la primera pantalla sin piedad.
- Haz que los resultados se verifiquen solos. Cuando un guardado imprime "Guardado en disco" con las rutas de los archivos, el agente deja de gastar llamadas comprobándolo.
- Dale a cada error un paso siguiente. Un error que nombra las opciones válidas convierte un callejón sin salida en una llamada más.
- Mide con una evaluación de arranque en frío. Usa un modelo pequeño, un proyecto nuevo y una comprobación del estado final real. Lee las transcripciones, cambia una cosa y vuelve a medir.
Pruébalo
Los nuevos comandos ya están en la última versión de cada plugin de motor: unity-mcp-cli 1.11.1, unreal-mcp-cli 0.31.1 y godot-cli 0.39.1. Si unity-mcp-cli --help (o el equivalente en Unreal o Godot) no lista rql y tools, estás en una versión anterior, y el comando update te lleva a la última.
npx unity-mcp-cli tools
npx unity-mcp-cli rql 'objects | where name starts-with "Tree" | count'
npx unity-mcp-cli compile
npx unity-mcp-cli setup-skills claude-codenpx unreal-mcp-cli tools --filter rql
npx unreal-mcp-cli rql 'actors | where Label starts-with "Rock" | set Scale = Scale * 1.5'
npx unreal-mcp-cli rql 'editor | call SaveLevel()'npx godot-cli rql 'nodes | where name contains "Enemy" | count'
npx godot-cli check
npx godot-cli setup-skills claude-codeEl primer comando de editor arranca un editor sin interfaz y lo mantiene caliente, así que no hace falta abrir el motor antes. Un cambio hecho con rql imprime qué cambió y qué archivos se escribieron, para que tu agente pueda pasar directamente al siguiente paso.
Empieza aquí
- Unity: ai-game.dev/engines/unity
- Unreal Engine: ai-game.dev/engines/unreal
- Godot: ai-game.dev/engines/godot
- El lenguaje de consultas RQL: ai-game.dev/docs/rql
- Guía de inicio rápido: ai-game.dev/docs/quickstart
- Comunidad de Discord: https://discord.gg/cfbdMZX99G
Seguiremos ejecutando estas evaluaciones de arranque en frío a medida que las CLI crezcan. Si tu agente se atasca en algún sitio, cuéntanoslo en Discord: una transcripción de dónde falló es exactamente lo que necesitamos.